刚接触 AI 时,很容易听到这些说法:
- “我在用 DeepSeek。”
- “豆包也是一个大模型。”
- “Codex 和 Claude Code 哪个模型更强?”
- “Agent 和大模型有什么区别?”
- “GPT、Claude、DeepSeek 都属于 LLM 吗?”
这些说法有时正确,有时又不够准确。根本原因是:我们经常把公司、模型、应用、开发平台和 Agent 产品混在一起讨论。
本文尝试把这些概念放回各自的位置。
一、先记住这五个层次
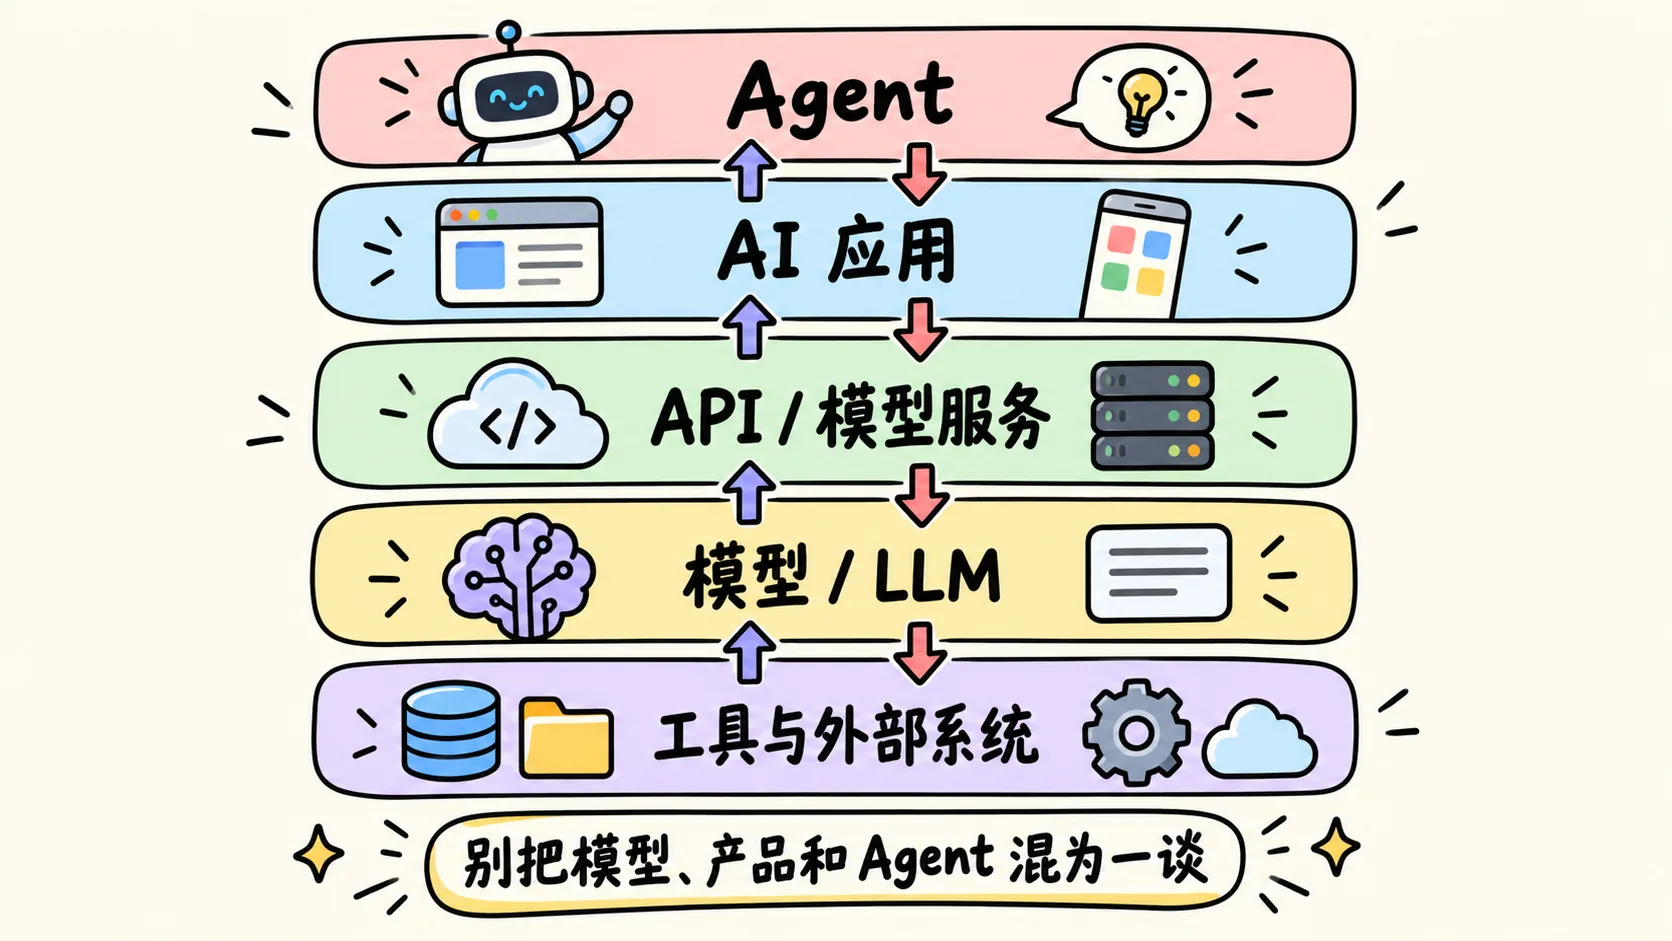
理解 AI 产品,最重要的不是背名字,而是先分清下面五层:
厂商或品牌
  ↓ 研发
模型
  ↓ 提供
API / 模型服务
  ↓ 被集成到
应用或 Agent
  ↓ 使用
工具、文件、浏览器、代码仓库和业务系统
以 OpenAI 为例:
OpenAI                    厂商
  ├── GPT 系列             模型
  ├── OpenAI API           模型服务接口
  ├── ChatGPT              通用 AI 应用
  └── Codex                编程 Agent
同理,字节跳动、DeepSeek、Anthropic 等厂商,也分别提供模型、API 和面向用户的应用。
二、什么是 AI 模型?
模型可以理解为 AI 系统中的“能力引擎”。它经过大量数据训练,可以根据输入计算并生成输出。
不同模型可能擅长不同任务:
- 文本理解与生成
- 逻辑推理
- 编写代码
- 识别图片
- 生成图片或视频
- 语音识别与合成
- 向量化和语义检索
因此,“模型”是一个大类,LLM 只是模型中的一种。
三、什么是 LLM?
LLM 是 Large Language Model 的缩写,中文通常称为“大语言模型”。
它主要处理语言相关任务,例如:
- 回答问题
- 总结文章
- 翻译文本
- 编写代码
- 提取结构化信息
- 根据上下文推理
GPT、Claude、DeepSeek、Gemini、Qwen 等模型系列,都可以包含 LLM。
不过现在很多模型已经不只处理文字,还可以理解图片、音频和视频。这类模型通常称为多模态模型。日常交流中,人们仍然可能宽泛地把它们称为“大模型”或 LLM。
可以简单理解为:
AI 模型
├── 大语言模型
├── 多模态模型
├── 图像生成模型
├── 视频生成模型
├── 语音模型
└── Embedding 等其他模型
四、模型和 AI 应用有什么区别?
模型是底层能力,AI 应用是用户真正使用的软件。
模型 ≈ 发动机
AI 应用 ≈ 一辆完整的汽车
仅有模型通常还不够。一个完整应用还可能提供:
- 聊天界面
- 文件上传
- 联网搜索
- 历史会话
- 知识库
- 语音交互
- 图片生成
- 工具调用
- 账号、权限和计费
同一个应用也不一定永远只使用一个模型。它可以根据任务、套餐或用户选择切换不同模型。
反过来,同一个模型也可以被多个不同应用通过 API 调用。
五、豆包到底是什么?
“豆包”在不同语境中可能指两类东西。
1. 豆包应用
普通用户手机或网页上使用的“豆包”,是一个完整的 AI 助手应用。它提供聊天、搜索、语音、创作等用户功能。
2. 豆包大模型
开发者讨论的“豆包模型”,通常指字节跳动的模型系列。企业或开发者可以通过火山引擎的模型服务平台调用这些模型。
因此,下面两句话可能分别指不同对象:
“我打开豆包问了一个问题”       → 豆包应用
“系统后端接入了豆包模型”       → 豆包大模型或模型 API
豆包不是单纯等于一个模型名称,而是同时覆盖了面向用户的产品品牌和一系列底层模型服务。
六、DeepSeek 到底是什么?
“DeepSeek”同样是一个多义名称,可能表示:
- 公司或品牌:研发并提供相关模型与服务的团队。
- 模型系列:不同用途和能力的 DeepSeek 模型。
- 网页或手机应用:普通用户直接聊天的 AI 助手。
- API 服务:开发者通过 API Key 调用模型的接口。
所以“使用 DeepSeek”至少可能有三种方式:
在 DeepSeek App 中聊天
通过 DeepSeek API 调用模型
在 Dify、Codex 等其他工具中配置 DeepSeek 作为底层模型
第三种情况尤其重要:上层应用和底层模型可以来自不同厂商。
例如,一个编程 Agent 的界面和工具能力由 A 公司提供,但底层推理模型可能来自 B 公司。此时,不能只看到模型名称就把整个应用也当成该模型厂商的产品。
七、什么是 Agent?
普通的模型调用通常是:
用户输入 → 模型生成回答
Agent 则会在模型外面增加目标、工具、上下文和执行循环:
接收目标
  ↓
分析与规划
  ↓
选择并调用工具
  ↓
观察工具结果
  ↓
继续执行或调整计划
  ↓
完成任务
一个 Agent 通常由这些部分组成:
- 模型:理解需求、推理并作出决策。
- 指令:规定目标、角色、规则和边界。
- 工具:搜索网页、读写文件、执行代码、调用 API 等。
- 上下文或记忆:保存任务过程中的信息。
- 编排逻辑:控制模型与工具之间的循环。
- 权限与安全机制:限制 Agent 可以执行的动作。
因此:
Agent 不是另一种和 LLM 并列的模型,而是以模型为核心,组合工具和执行流程形成的任务系统。
可以用一个简单类比:
LLM:会思考和表达的大脑
工具:可以操作外部世界的手脚
Agent:带着目标,能调动大脑和手脚完成任务的系统
八、聊天机器人和 Agent 有什么区别?
传统聊天机器人主要目标是“给出回答”,Agent 更强调“完成任务”。
| 对比项 | 普通聊天应用 | Agent |
|---|---|---|
| 主要产物 | 一段回答 | 一个完成的任务或可验证结果 |
| 工具使用 | 可能没有或较少 | 通常可以调用多种工具 |
| 执行过程 | 一问一答 | 可以多步骤规划、执行和调整 |
| 外部操作 | 通常较弱 | 可以操作文件、代码、网页或业务系统 |
| 自主程度 | 相对较低 | 相对较高,但仍应受权限控制 |
不过二者并没有绝对边界。现在很多聊天应用也逐渐加入搜索、文件分析和工具调用能力,开始具备 Agent 特征。
九、什么是编程 Agent?
编程 Agent 是专门面向软件开发任务的 Agent。
它不仅能在聊天框中生成代码,还可以在获得权限后:
- 阅读整个代码仓库
- 搜索函数和调用关系
- 修改多个文件
- 执行命令
- 运行测试和分析错误
- 查看 Git 差异
- 修复缺陷
- 进行代码审查
- 与 GitHub、GitLab 或其他开发工具协作
普通代码模型更像“告诉你代码应该怎么写”,编程 Agent 更像“进入项目后直接把任务做完并验证结果”。
十、Codex 是什么?
Codex 是 OpenAI 面向软件开发的编程 Agent,而不是某一个固定模型的同义词。
它可以通过桌面应用、命令行、IDE 等形态工作,结合模型与工具来完成代码阅读、编辑、调试、测试和审查等任务。
可以把 Codex 拆成两层理解:
Codex:编程 Agent / Agent 运行与工具环境
   ↓ 使用
OpenAI 模型或其他已配置模型:负责理解和推理
这也是为什么“Codex 用什么模型”和“Codex 是什么”是两个不同问题:
- Codex 是执行软件工程任务的 Agent 产品和工作环境。
- 模型是 Codex 在某次任务中使用的推理引擎。
在不同配置、版本或使用方式下,Codex 可以使用不同模型,因此不宜简单地说“Codex 就是某个模型”。
十一、Claude Code 是什么?
Claude Code 是 Anthropic 提供的编程 Agent。它可以在开发环境中读取代码、编辑文件、执行命令,并围绕软件工程任务持续工作。
同样需要区分:
Claude:Anthropic 的模型系列或 AI 品牌
Claude 应用:面向用户的通用 AI 助手
Claude Code:面向软件开发的编程 Agent
因此,Claude Code 也不等于某一个 Claude 模型。它是一个使用模型、工具和 Agent 循环完成编程任务的产品。
十二、Codex 和 Claude Code 属于模型吗?
不应把它们简单归类为模型。
更准确的分类是:
| 名称 | 更准确的类别 | 说明 |
|---|---|---|
| LLM | 模型类别 | 处理和生成语言的大型神经网络 |
| GPT | 模型系列 | OpenAI 的模型系列名称 |
| Claude | 模型系列与产品品牌 | 具体含义取决于上下文 |
| DeepSeek | 公司、模型系列、应用或 API 品牌 | 同一个名字覆盖多个层次 |
| 豆包 | AI 应用与模型品牌 | 既有用户产品,也有底层模型服务 |
| Agent | 系统形态 | 使用模型、工具和流程完成目标 |
| Codex | 编程 Agent | OpenAI 的软件开发 Agent |
| Claude Code | 编程 Agent | Anthropic 的软件开发 Agent |
| Dify | AI 应用开发平台 | 用于编排模型、知识库、工作流和 Agent |
| MCP | 协议 | 让 AI 应用以标准方式连接外部能力 |
十三、模型、Agent、工具和 MCP 如何组合?
把上一篇 MCP 的内容接进来,完整关系可以表示为:
用户
  ↓
AI 应用 / Agent Host(Dify、Codex、Claude Code 等)
  ├── 调用模型:理解、推理、选择动作
  ├── 管理上下文:保存任务相关信息
  └── 调用工具:执行具体操作
         ↓
      MCP Client
         ↓ MCP 协议
      MCP Server
         ↓
      GitLab、数据库、本地文件等外部系统
这里每一层解决的问题不同:
- 模型解决“怎么理解和推理”。
- Agent解决“怎么围绕目标持续行动”。
- 工具解决“怎么真正执行操作”。
- MCP解决“怎么用统一协议连接外部能力”。
- 应用界面解决“用户怎么方便地使用这些能力”。
十四、API 和 API Key 又是什么?
如果把模型集成到自己的程序中,通常不会直接使用厂商的聊天网页,而是调用模型 API。
自己的应用
  ↓ API 请求
模型服务平台
  ↓
模型
- API 是程序之间约定的调用接口。
- API Key 是调用服务时的身份凭证。
- 模型名称或 Model ID 用于指定本次想调用哪个模型。
例如,在 Dify 中配置 DeepSeek 时,需要填写 DeepSeek API Key,并选择有权限使用的模型。这并不意味着 Dify 变成了 DeepSeek,而是 Dify 把 DeepSeek 作为底层模型服务之一。
十五、几个常见误区
误区一:所有 AI 产品都是大模型
不准确。豆包 App、ChatGPT、Codex、Claude Code 等都是包含模型在内的完整产品或 Agent,不只是裸模型。
误区二:Agent 是一种更强的大模型
不准确。Agent 是系统形态。它可能使用一个或多个模型,并组合工具、记忆和执行流程。
误区三:Codex 就是一个代码模型
不准确。Codex 更适合被理解为编程 Agent;它使用模型完成推理,同时具备读取项目、修改文件和执行工具的能力。
误区四:Claude 和 Claude Code 是同一个东西
不准确。Claude 通常指模型系列或通用 AI 品牌,Claude Code 是面向开发工作的 Agent 产品。
误区五:一个应用只能使用一个模型
不一定。很多 AI 应用和开发平台都支持选择或配置多个模型。
误区六:模型越强,Agent 就一定越好
不一定。Agent 的效果还取决于工具设计、提示词、上下文管理、权限、编排逻辑和验证机制。
十六、如何快速判断一个新名词属于哪一层?
遇到新的 AI 名称时,可以依次问五个问题:
- 它是一家公司或品牌吗?
- 它是一个可以通过 Model ID 调用的模型吗?
- 它是一个有界面、账号和功能的应用吗?
- 它能否自主调用工具并执行多步骤任务?
- 它是用于连接、开发或部署模型的平台与协议吗?
同一个名字可能同时对应多个答案,这时必须结合上下文判断。
例如:
“DeepSeek 发布了新模型”         → 公司或品牌
“接口使用 DeepSeek 模型”        → 模型或 API 服务
“我在 DeepSeek 里问了一下”      → 网页或手机应用

“Claude 的推理能力不错”         → Claude 模型
“用 Claude Code 修改项目”       → 编程 Agent
十七、一句话总结
如果只记住一套关系,可以记住下面这段:
LLM 是负责理解和生成语言的模型;模型是 AI 系统的能力引擎;豆包和 DeepSeek 等名称可能同时指品牌、模型、应用或 API;Agent 是组合模型、工具和执行流程来完成目标的系统;Codex 与 Claude Code 是面向软件开发的编程 Agent,而不是单一模型。
最终,现代 AI 应用往往是这样工作的:
用户提出目标
  ↓
Agent 调用模型进行理解与决策
  ↓
Agent 调用工具执行操作
  ↓
根据结果继续行动或完成任务
模型决定“能不能想明白”,工具决定“能不能做得到”,而 Agent 决定“能不能围绕目标把事情做完”。